
构词: Glow(萤火微光)+sprie(低语,螺旋,也有启迪之意)
界面介绍
UI 界面
设置内容
外观设置
整体以萤火虫为主题,以浅绿色作为主题色,采用可调节透明度的毛玻璃材质
聊天
- 背景虚化程度变化滑钮
- 使用模型的名称和版本
TT 语音
- 填入 MinMax API 密钥
- 音色克隆 id
- 设置前置静音时长
- 语音播放开关
ASR 设置
- 语音识别开关
- GPU 加速开关
- 说话方式选择(按住说话/自由说话)
- 识别后发送方式(先填入输入框,确认之后再手动发送/识别完自动发送)
- 识别的模型
- 识别质量/速度选择
- VAD 灵敏度设置
- 静默判定时长设置
声纹管理
- 声纹门禁开关
- 声纹严格程度
- 声纹录入功能
- 麦克风检查是否可用
- 输入电平表+频谱柱状图
- 声纹录制的提示词引导
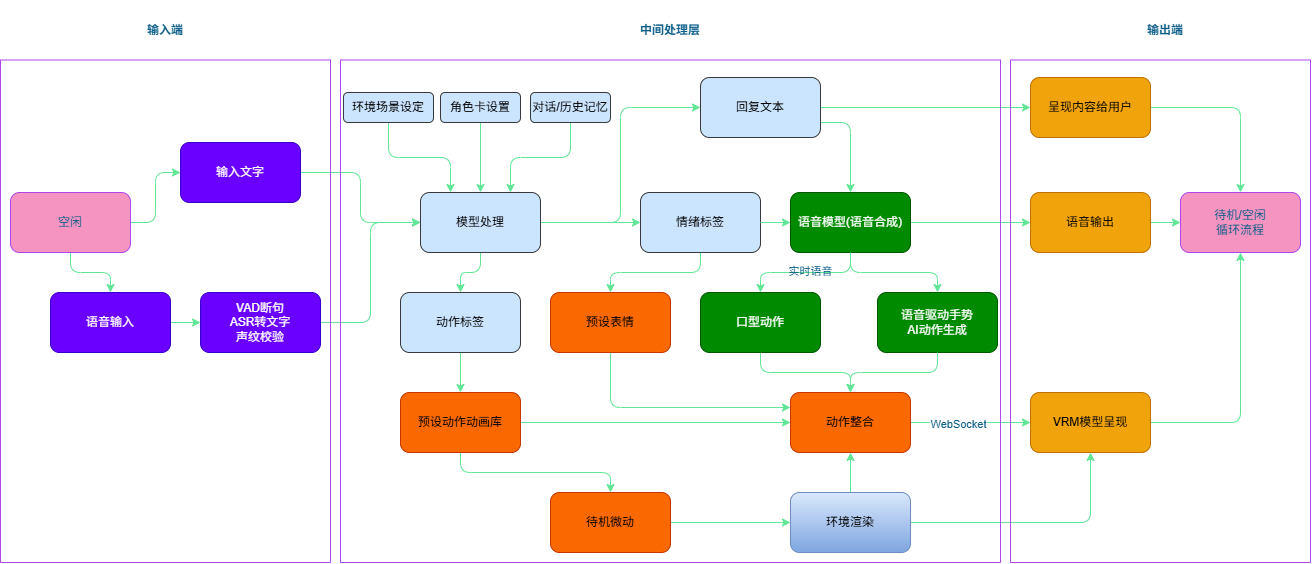
角色模型整体(大脑+声音+形象模型)
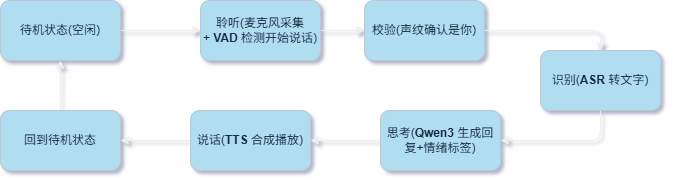
整个聊天室本质是一个循环状态机:
选 Qwen 的小模型作为训练对象,用 Unsloth + QLoRA 微调
下面用 qwen3.5-9B 模型演示流程,因为最后有多个版本
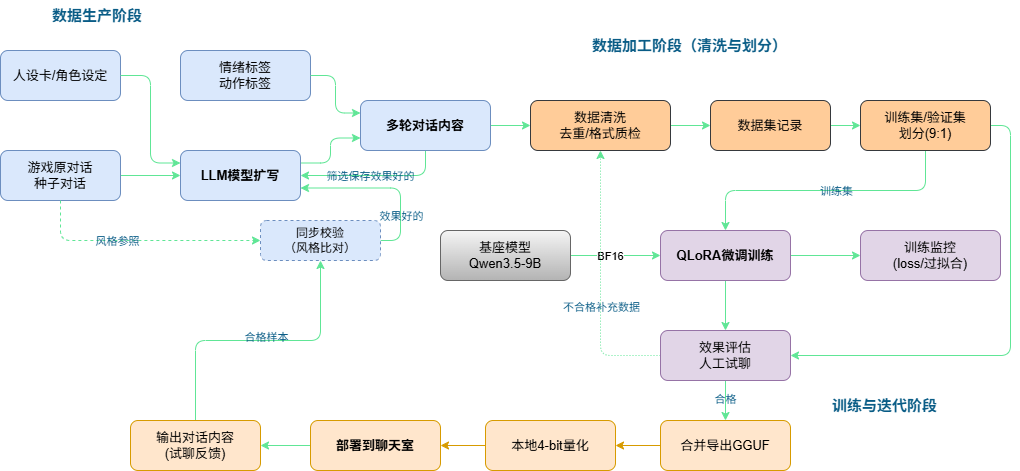
效果: 模型体量小,数据干净,满足聊天模型的需求 1. 本地部署本地跑,无费用消耗 2. 模型体量小,性能要求低,回复速度快 3. 数据干净,角色扮演效果好
本地模型训练(基座模型 + 持续喂数据微调)
- 配置环境: 选用阿里云端开发环境/魔塔社区一条龙部署(优先)
- 数据来源: 选用游戏原对话作为”种子对话”,调用其他大模型进行扩写
- 定向扩展: 对扩写内容进行润色,筛选,添加偏向预期性格的内容
Unsloth + QLoRA 微调
第一步:数据准备
格式上,Qwen3 用的是ChatML对话格式,所以对话数据集要按ShareGPT风格组织成 JSONL,每条是一段多轮对话:
{"conversations": [
  {"from": "system", "value": "人设卡部分"},
  {"from": "human", "value": "今天好累啊"},
  {"from": "gpt", "value": "怎么啦?过来,跟我说说。"}
]}
记住人设卡是”她”人格的锚点. 然后按之前说的策略:游戏里导出种子对话 → 进行数据筛选和去重 + 编写数据合并 → 训练空白模型(未经过微调,仅保证人设) → 试训得到数据进行数据清洗后加入数据集,数据里的对话轮次要有长短变化(1 轮到 8 轮都有),情绪要多样,否则模型只会复读一种句式,白费功夫。
第二步:4-bit 加载模型
from unsloth import FastLanguageModel
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name="unsloth/Qwen3.5-4B",   # 云上16G档;本地8G卡换成 Qwen3.5-4B
    max_seq_length=2048,
    load_in_4bit=True,               # 4-bit NF4 量化 + 双重量化
)
QLoRA 的原理就是:基座模型冻结不动,用 4-bit 量化压缩到原来的四分之一显存,只训练挂在旁边的 LoRA 适配器(一小撮低秩矩阵)。8B 模型量化后约 4-5GB,加上优化器状态和激活值,16GB 显存很宽裕。
第三步:挂 LoRA 适配器
model = FastLanguageModel.get_peft_model(
    model,
    r=16,                     # 角色类任务 16-32 够用
    lora_alpha=16,
    lora_dropout=0,
    target_modules=["q_proj","k_proj","v_proj","o_proj",
                    "gate_proj","up_proj","down_proj"],
)
r 是低秩维度,可以理解为”给模型留了多少可塑空间”。r=16 意味着要训练的参数只有几百 MB,这就是为什么 8GB 也能训练 8B 模型,其实只动了模型 1% 不到的参数。
第四步:训练超参数
学习率 5e-5 起步,epoch 先设 1(角色微调经常一轮就够,多轮极易过拟合成人设复读机),batch size 2 + 梯度累积 4,优化器用 adamw_8bit 省显存,训练时监控 loss。这里有个反直觉的点:loss 越低不代表模型越好,训练 loss 在降而验证集 loss 在升,就是模型在背你的数据集,跟”她”聊新话题就会崩。我记录中的极差最大的比最小大了 3 倍之高
第五步:中途验证效果
训练完先不合并,用验证集那 10-15% 的样本让模型生成回复,跟基座模型对照。检查三件事:回复是否遵循人设、语气是否一致、有没有复读训练数据原文。如果微调后跟基座输出几乎没差别,说明适配器没生效(检查有没有加载对 checkpoint)。
第六步:合并与导出
LoRA 适配器本身不能独立部署,要合并回基座:model.save_pretrained_merged() 得到完整权重,再用 llama.cpp 的 convert_hf_to_gguf.py 导出 GGUF 格式,量化选 Q5_K_M(8B 模型约 4.6GB)。然后写个 Ollama Modelfile 就能本地加载了。
第七步:部署聊天 + 收集问题 + 迭代循环
这一步必须强调:训练和推理时的 prompt 模板要完全一致。在训练数据里 system 字段写了人设卡,推理时就必须同样把人设卡放进 system 位置,格式错一点,模型的表现就掉一档。部署后进入迭代循环:跟”她”聊 → 记录人设崩掉的场景 → 针对这些场景补数据 → 再训一轮。每次迭代的数据集才是真正的资产,为后面的模型训练垫基。
角色音声模型+AEC 回声消除+VAD+声纹校验+活检(活体检测)+ASR+TTS 合成
效果: 复刻角色独有音色,会断句,有情绪语气语调,能识别个人音色 1. 能复刻你想要的角色声色 2. 说话有情绪,更贴近真人,说话更生动 3. 只对你说话有响应,只认你的声音,是你的个人专属盆友哦
云端或本地部署,输出情绪,有语气,tts 接口选择
- 音色克隆: minimax 克隆 id/本地训练音色模型
- 声纹校验: 现技术较成熟,使用 CAM++可简单精准的实现
- 情绪输出: 把情绪标注能力”蒸馏”进微调模型/二次调用分析情绪关键词
- tts 接口: minimax 的 tts 接口(付费)/本地 tts 模型(GPT-SoVITS 完全免费)
注意事项:
- 本地 tts 模型免费但是效果差,且比较占性能,minimax 付费但较便宜,效果更好
- 隐私问题,因为一旦调用 tts 接口,消息暴露,对于该项目存在问题,不介意的话推荐选付费
第一步: 音色克隆
推荐选择MiniMax 的官方克隆,需要谷歌账户登录,且首次克隆需要花费额度,只能充值,上传 10 秒以上的人声(越纯净越好),直接克隆生成就行,会获取克隆模型的 id,后续直接在接口中填写该克隆音色 id 即可,或者走 GPT-SoVITS 的微调流程产出 .ckpt 权重文件. 这一步的关键就在素材的质量,直接决定了成品效果。
第二步: 音频采集
这一步就是把麦克风收到的声音变成程序能用的数字数据(PCM)。Electron 是 Chromium 内核,用 getUserMedia 打开麦克风拿到音频流,再接到 Web Audio 上:AudioContext + AudioWorkletNode,由 AudioWorklet 在音频线程上把声音切成 512 个样本一帧,逐帧抛回主线程。
采样率统一按 16 kHz 走,因为本地 whisper 只接受 16 kHz。麦克风自己是按原生率交付的(我的御葵 D80 是 USB 动圈麦,通常 48 kHz),所以中间靠 new AudioContext({ sampleRate: 16000 }) 让 Chromium 内部做一次重采样 —— 不是设备本来就这么给。
没用 MediaRecorder 而是用 AudioWorklet:
- 它在音频线程上跑,主线程卡顿也不丢帧;
- 是一次开麦能供多方复用 —— 电平表/频谱、送识别的音频帧、声纹录入的录音都取同一路流,避免反复开麦(会触发授权弹窗和设备独占)。
采到的帧在主线程按 512 样本拼成整段,打包成 16 kHz WAV,POST /asr 交给本地 whisper。
这一步的关键就在采样率
第三步: AEC 回声消除
AEC 回声清除,这个的功能就是为了把设备自己放的歌/说的话,从麦克风里消掉
我的回声主要来源就是自己的 TTS 从扬声器播出来的声音。Electron 是 Chromium 内核,getUserMedia({ audio: { echoCancellation: true, noiseSuppression: true, autoGainControl: true } }) 直接启用 WebRTC 的 AEC,只要采集和播放发生在同一个 Electron 窗口里(我的情况正好满足),回声抑制效果就不错。
第四步:VAD 断句(Silero VAD)
VAD 是”她怎么知道你说完了”这个问题的答案,2026 年本地项目的标配是 silero-vad ,一个 1.7MB 的 ONNX 模型,纯 CPU 跑,自带 Python 库,对音频流逐帧输出”有没有人说话”的概率,逻辑是:检测到语音开始 → 持续累积音频 → 连续 500-800 毫秒静音判定为你这句话说完了 → 把这一整段音频切出来交给下一级,这 500-800ms 是”尾静音”,定短了容易截断你的话,定长了显得她反应慢.还有一个进阶功能叫打断(barge-in): 她在说话时,如果你开口了,VAD 立刻检测到,就中止 TTS 播放切回聆听状态.
第五步:声纹校验(CAM++)
CAM++ 模型(ModelScope 上有现成的,中文场景 SOTA)在 CPU 上处理 3 秒音频只要十几毫秒.流程是: 注册阶段录你 10-30 秒的话,提取出一个 192 维的声纹向量存到本地文件.运行时把 VAD 切出的同一段音频也提一个向量,算余弦相似度,超过阈值(CAM++ 一般取 0.7 左右)判定是你本人.注意它和 ASR 是两码事:ASR 识别”说的什么”,声纹只回答”是不是你”,把校验放在 ASR 之前,不是你的声音就直接丢弃,省一次 ASR 计算.
可选项: 活检 防止别人放录音冒充你 但是在这个项目里实用性不大,因为这个也并非是啥隐私应用,只是这里做了声纹检验之后可以加入活检在你的声音上加一层锁,相关应用有微信的声音识别登录,和常规的声音开锁
- 实用路线(推荐):随机口令挑战——每次解锁时让萤语随机报 4-6 位数字让你跟读,ASR 验证内容 + 声纹验证身份,“内容对 + 声音对”双因子。实现简单,对抗普通录音重放够用。
- 学术路线:AASIST 之类的反欺骗模型,ONNX 也有,但误拒率调起来麻烦.
第六步:ASR 语音转文字(SenseVoice)
本地路线首选 whisper.cpp:和 llama.cpp 同门,二进制往 portable/ 里一扔,backend 子进程调用,和 llama.js 管理 llama-server 的代码模式一模一样,ggml-small 模型约 500MB,中文效果可用。
第七步:LLM 生成
把 ASR 的文本或者输入对话文本接到人设卡 system prompt 的完整对话历史里,然后模型输出结构化格式,比如 {“emotion”: “温柔”, “reply”: “怎么啦,过来跟我说说”},解析出两个字段,文本送 TTS,情绪映射成 TTS 参数. 这里我额外做了一层过滤层
- 过滤动作标签,即去除动作标签后发送给 TTS,不播放动作内容
- 过滤情绪标签和插入的语气词,发给用户看
第七步:TTS 合成与播放
现在用 MiniMax API:拿 voice_id + 文本 + emotion 参数请求合成(可以开 SSE 流式,边合成边播),返回音频流交给 pyaudio 播放,以后切本地方案时,GPT-SoVITS 自带 API 服务模式,代码层只改请求地址,胶水层逻辑一模一样,CosyVoice 2 的流式合成对延迟更友好,作为本地方案的升级选项.